Wide Events: cortando 80% do volume de log e melhorando a observabilidade
Um fluxo, 48 linhas de log, e o que muda quando você para de logar passos e passa a logar etapas.
Um sistema pode gerar centenas de linhas de log para contar a história de uma requisição.
Isso não é descuido, é o padrão. Uma autorização, por exemplo, atravessa vários serviços; cada um contribui com dezenas de linhas; no caminho inteiro, vira centena. A primeira coisa que isso te custa é dinheiro. A segunda, e a mais cara, é que ninguém consegue ler.
E quando o volume aperta, a saída costuma ser perder log, amostrar ou encurtar retenção — três formas diferentes de jogar informação fora.
Nesse ponto a resposta fácil está ali, barata o suficiente pra aprovar sem reunião: sobe o limite de ingestão, estende a retenção, toca a sprint. Todo time já tomou essa decisão, e na maioria das vezes é a decisão certa.
E aí vem a pergunta chata, que é a que explica por que vale seguir outro caminho:
Estamos resolvendo isso, ou estamos pagando pra não ter que resolver?
Responder passa por contar primeiro.
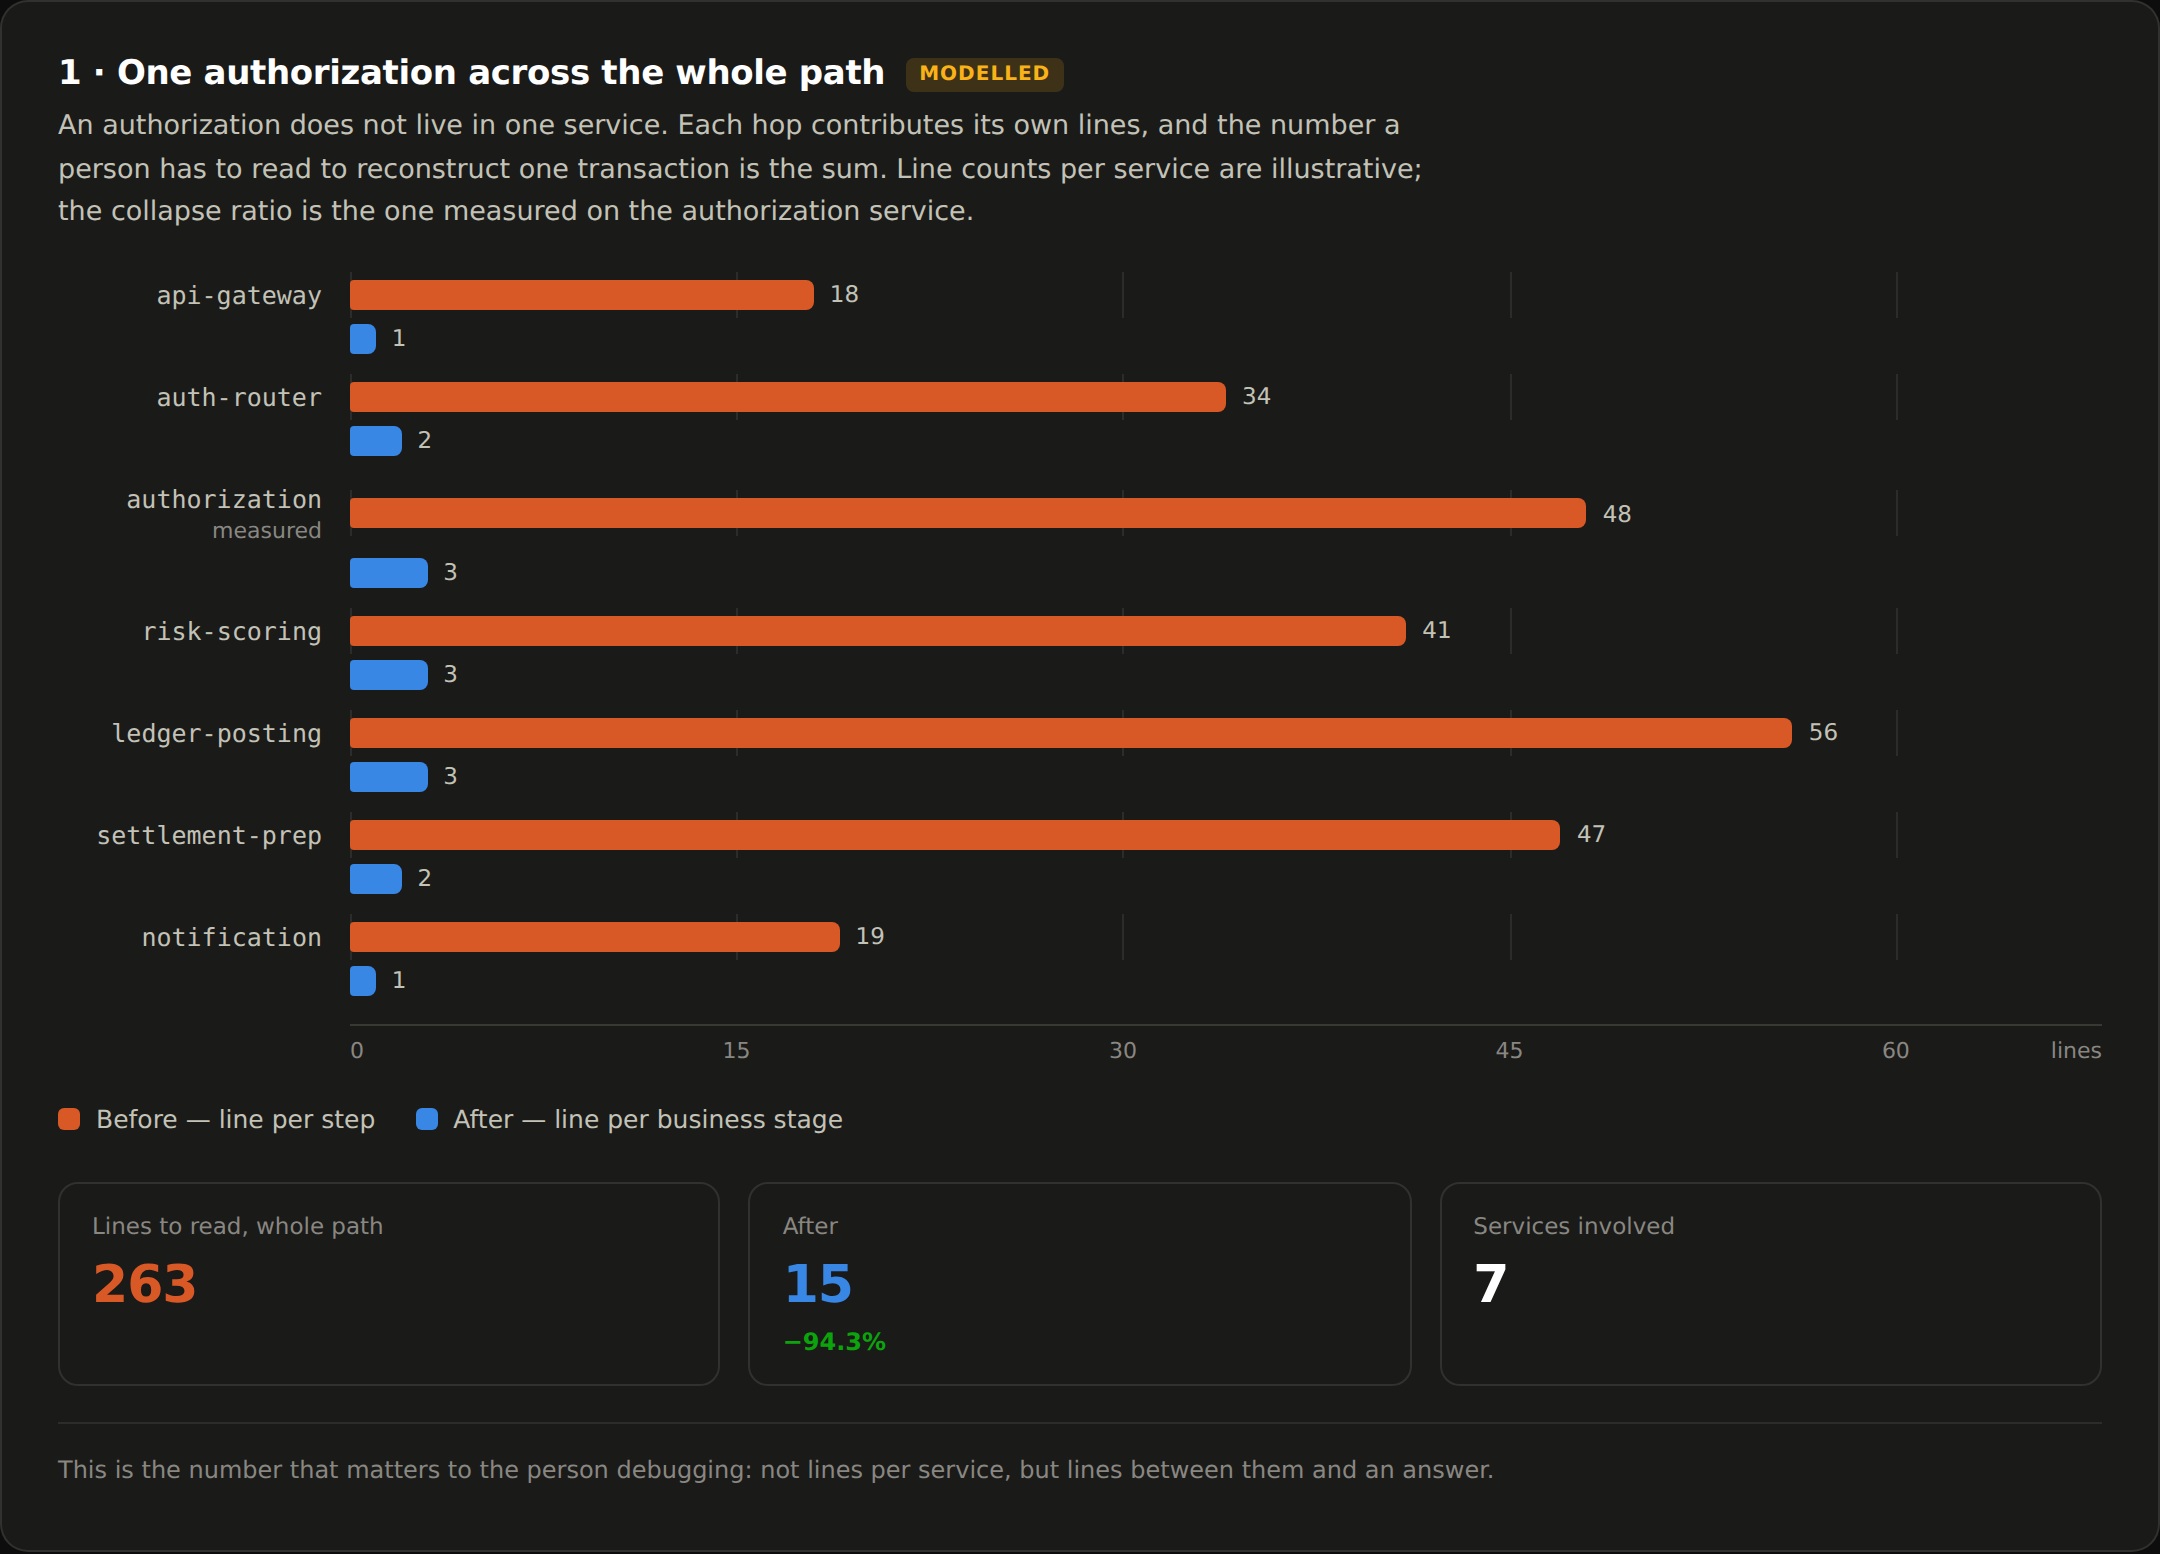
1. O que a contagem mostra
Pega um fluxo dentro de um único serviço de autorização — não o caminho todo, só um serviço. 48 linhas de log, produzidas por 14 loggers diferentes, pra um fluxo que terminou em 75 milissegundos.
Cada uma dessas linhas é verdadeira. Nenhuma delas serve sozinha:
[IntegrityLocker] Locking consumer
[HttpClient] Send POST https://fake-url.com/v1/receivables
[HttpClient] Receive response 200
[HttpClient] Send POST https://antifraude/v1/authorize
[HttpClient] Receive response 200
[Auth::UseCase] Validating responses
[Auth::UseCase] Processing authorization
[IntegrityLocker] Release integrity locker
[Server] Response built
Para entender uma única transação, alguém filtra por correlation id, ordena por timestamp, lê 48 linhas e subtrai timestamp na mão pra descobrir onde o tempo foi.
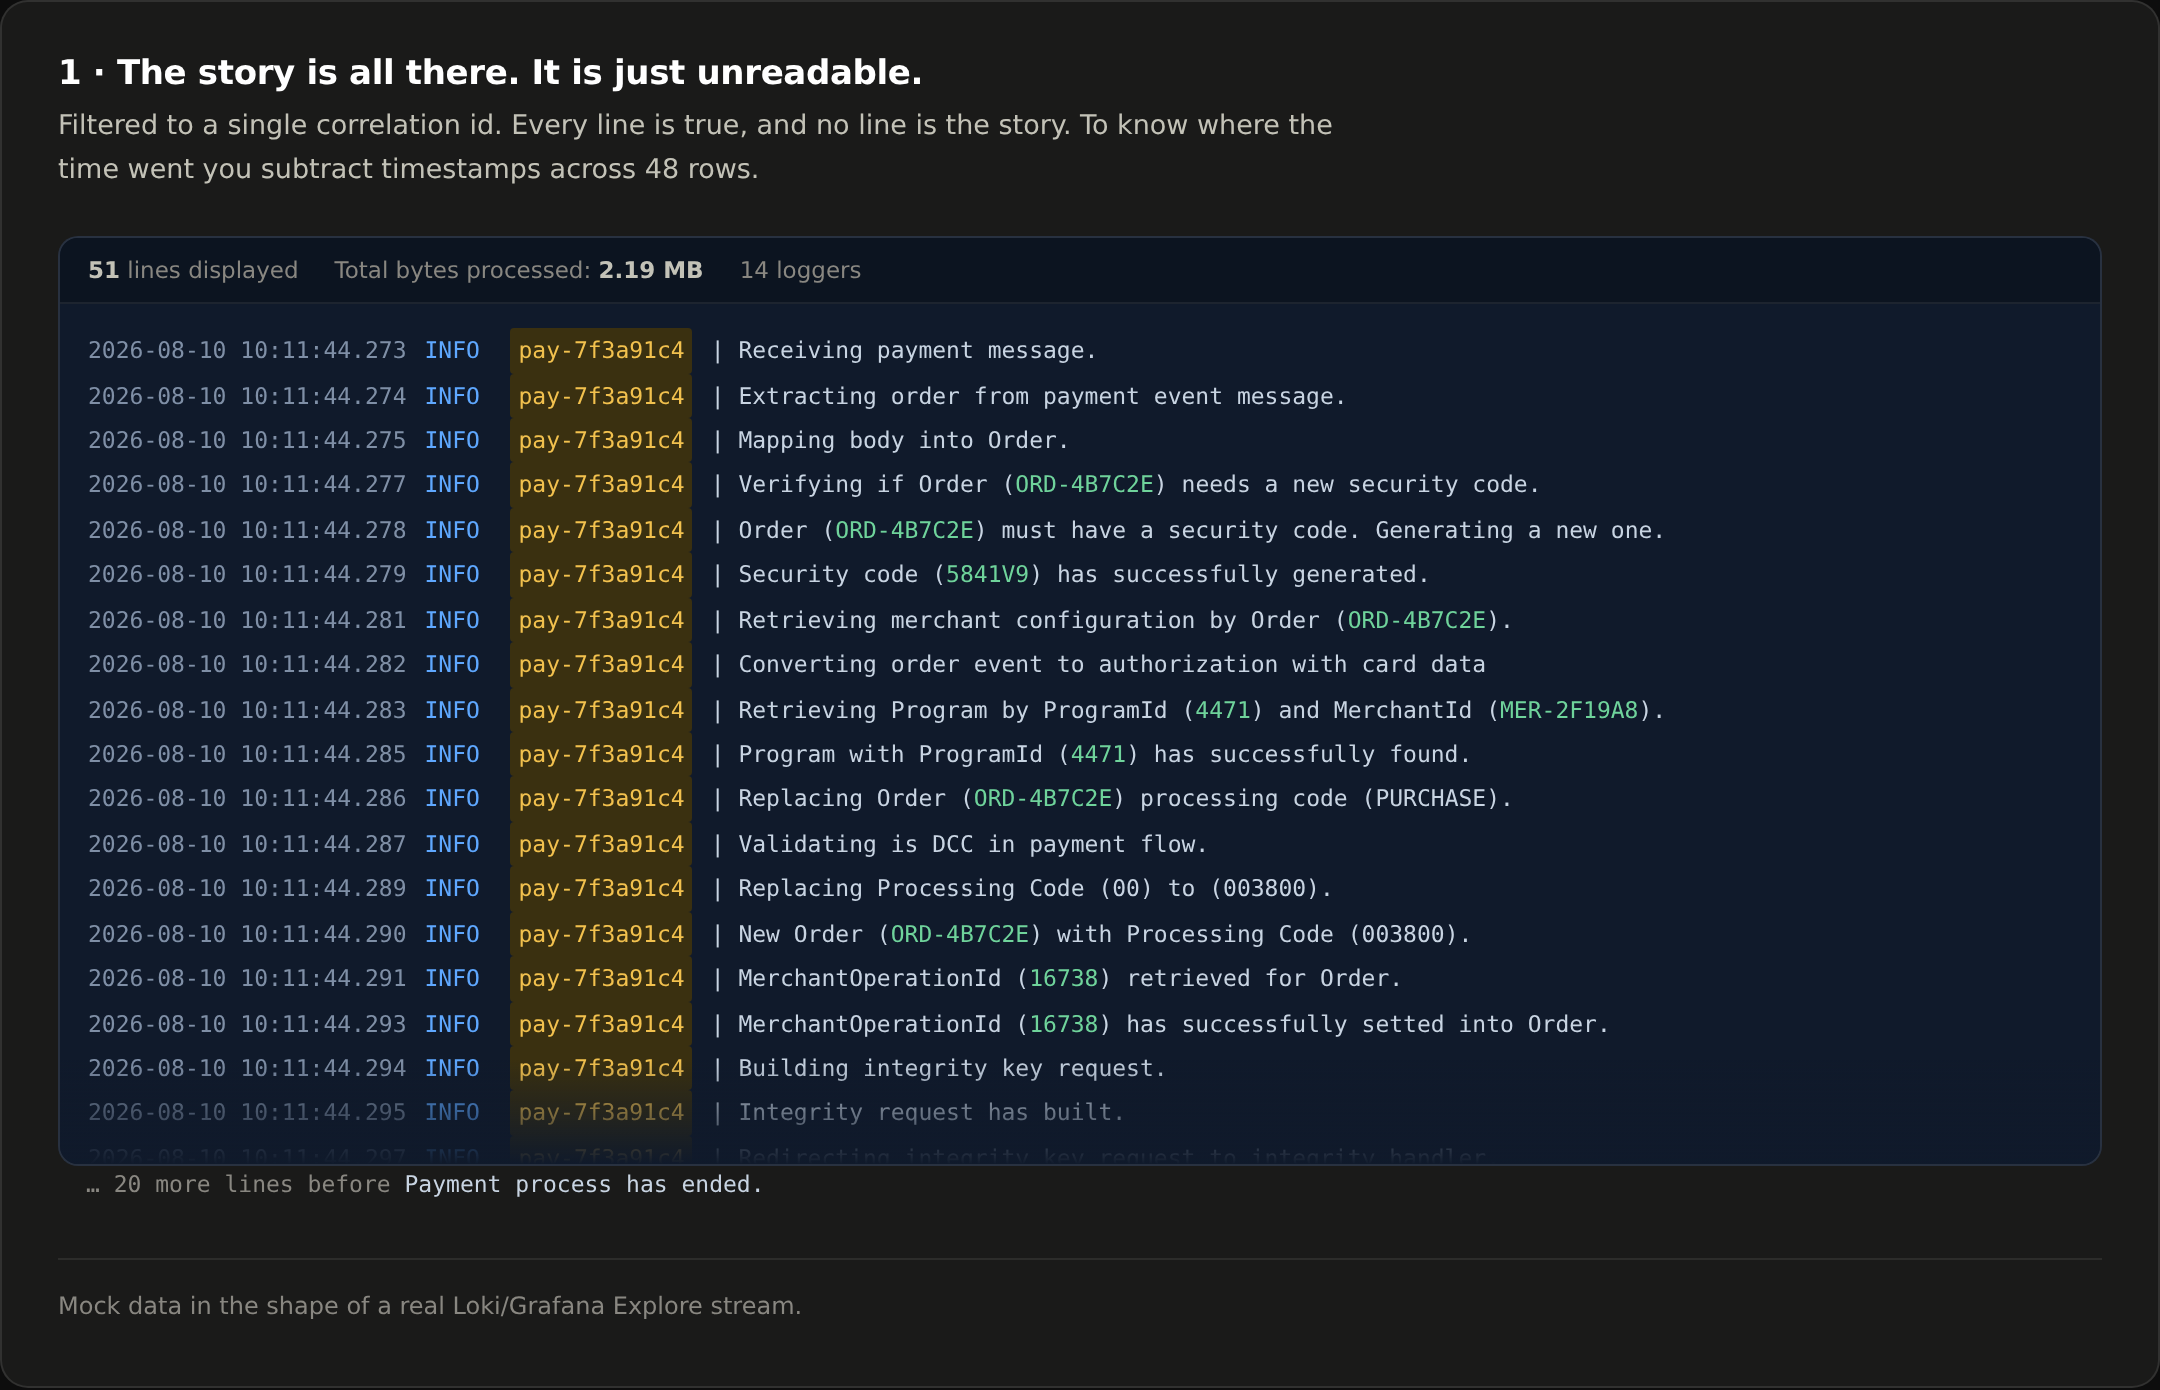
E vale parar aqui: ninguém decidiu logar 48 vezes. Cada linha entrou por um bom motivo, escrita por gente competente, em pull requests diferentes, ao longo de anos. Ninguém foi descuidado. O volume não foi projetado — ele se acumulou. Isso vale pra quase todo problema de log que eu já vi, e é por isso que "loga menos" é conselho inútil. Logar menos onde? Toda linha tem um autor que tinha um motivo.
2. De onde o volume realmente vem
Aqui está o pulo do gato.
Antes de mudar qualquer coisa, precisamos olhar do que uma linha de log é feita:
2026-08-10 10:11:44.443  INFO  [pay-7f3a91c4…2311]  AntifraudEvaluationService
[event-loop-thread-5]  pod=payments-api-6d9f4c7b85-x2knq  svc=payments-api  ver=v2.14.3
az=sa-east-1a  OrderId=ORD-4B7C2E  AuthorizationId=AUTH-8D31C2  MerchantId=MER-2F19A8
│ Performing antifraud evaluation.
Tudo antes do │ é carimbo. Tudo depois é o que aconteceu.
O carimbo é cobrado uma vez por linha, e é idêntico em todas as linhas do mesmo correlation id. Pra contar uma história, você paga por ele 48 vezes. É daí que o volume vem: não do que você está registrando, mas de quantas vezes você registra o contexto em volta.
Uma ressalva de precisão, porque é aqui que o argumento costuma ser exagerado e a pessoa leva
correção nos comentários: num sistema como o Loki, stream labels — cluster, namespace,
region, job — são indexados uma vez por stream, não uma vez por linha. Nesses campos
específicos, colapsar linhas não economiza nada. O que de fato encolhe é:
- o carimbo por linha — timestamp, severidade, nome do logger, thread, pod, versão do serviço, zona de disponibilidade;
- os identificadores de negócio repetidos dentro de todo payload;
- os bytes que suas queries precisam varrer, que é um custo real e cobrado à parte.
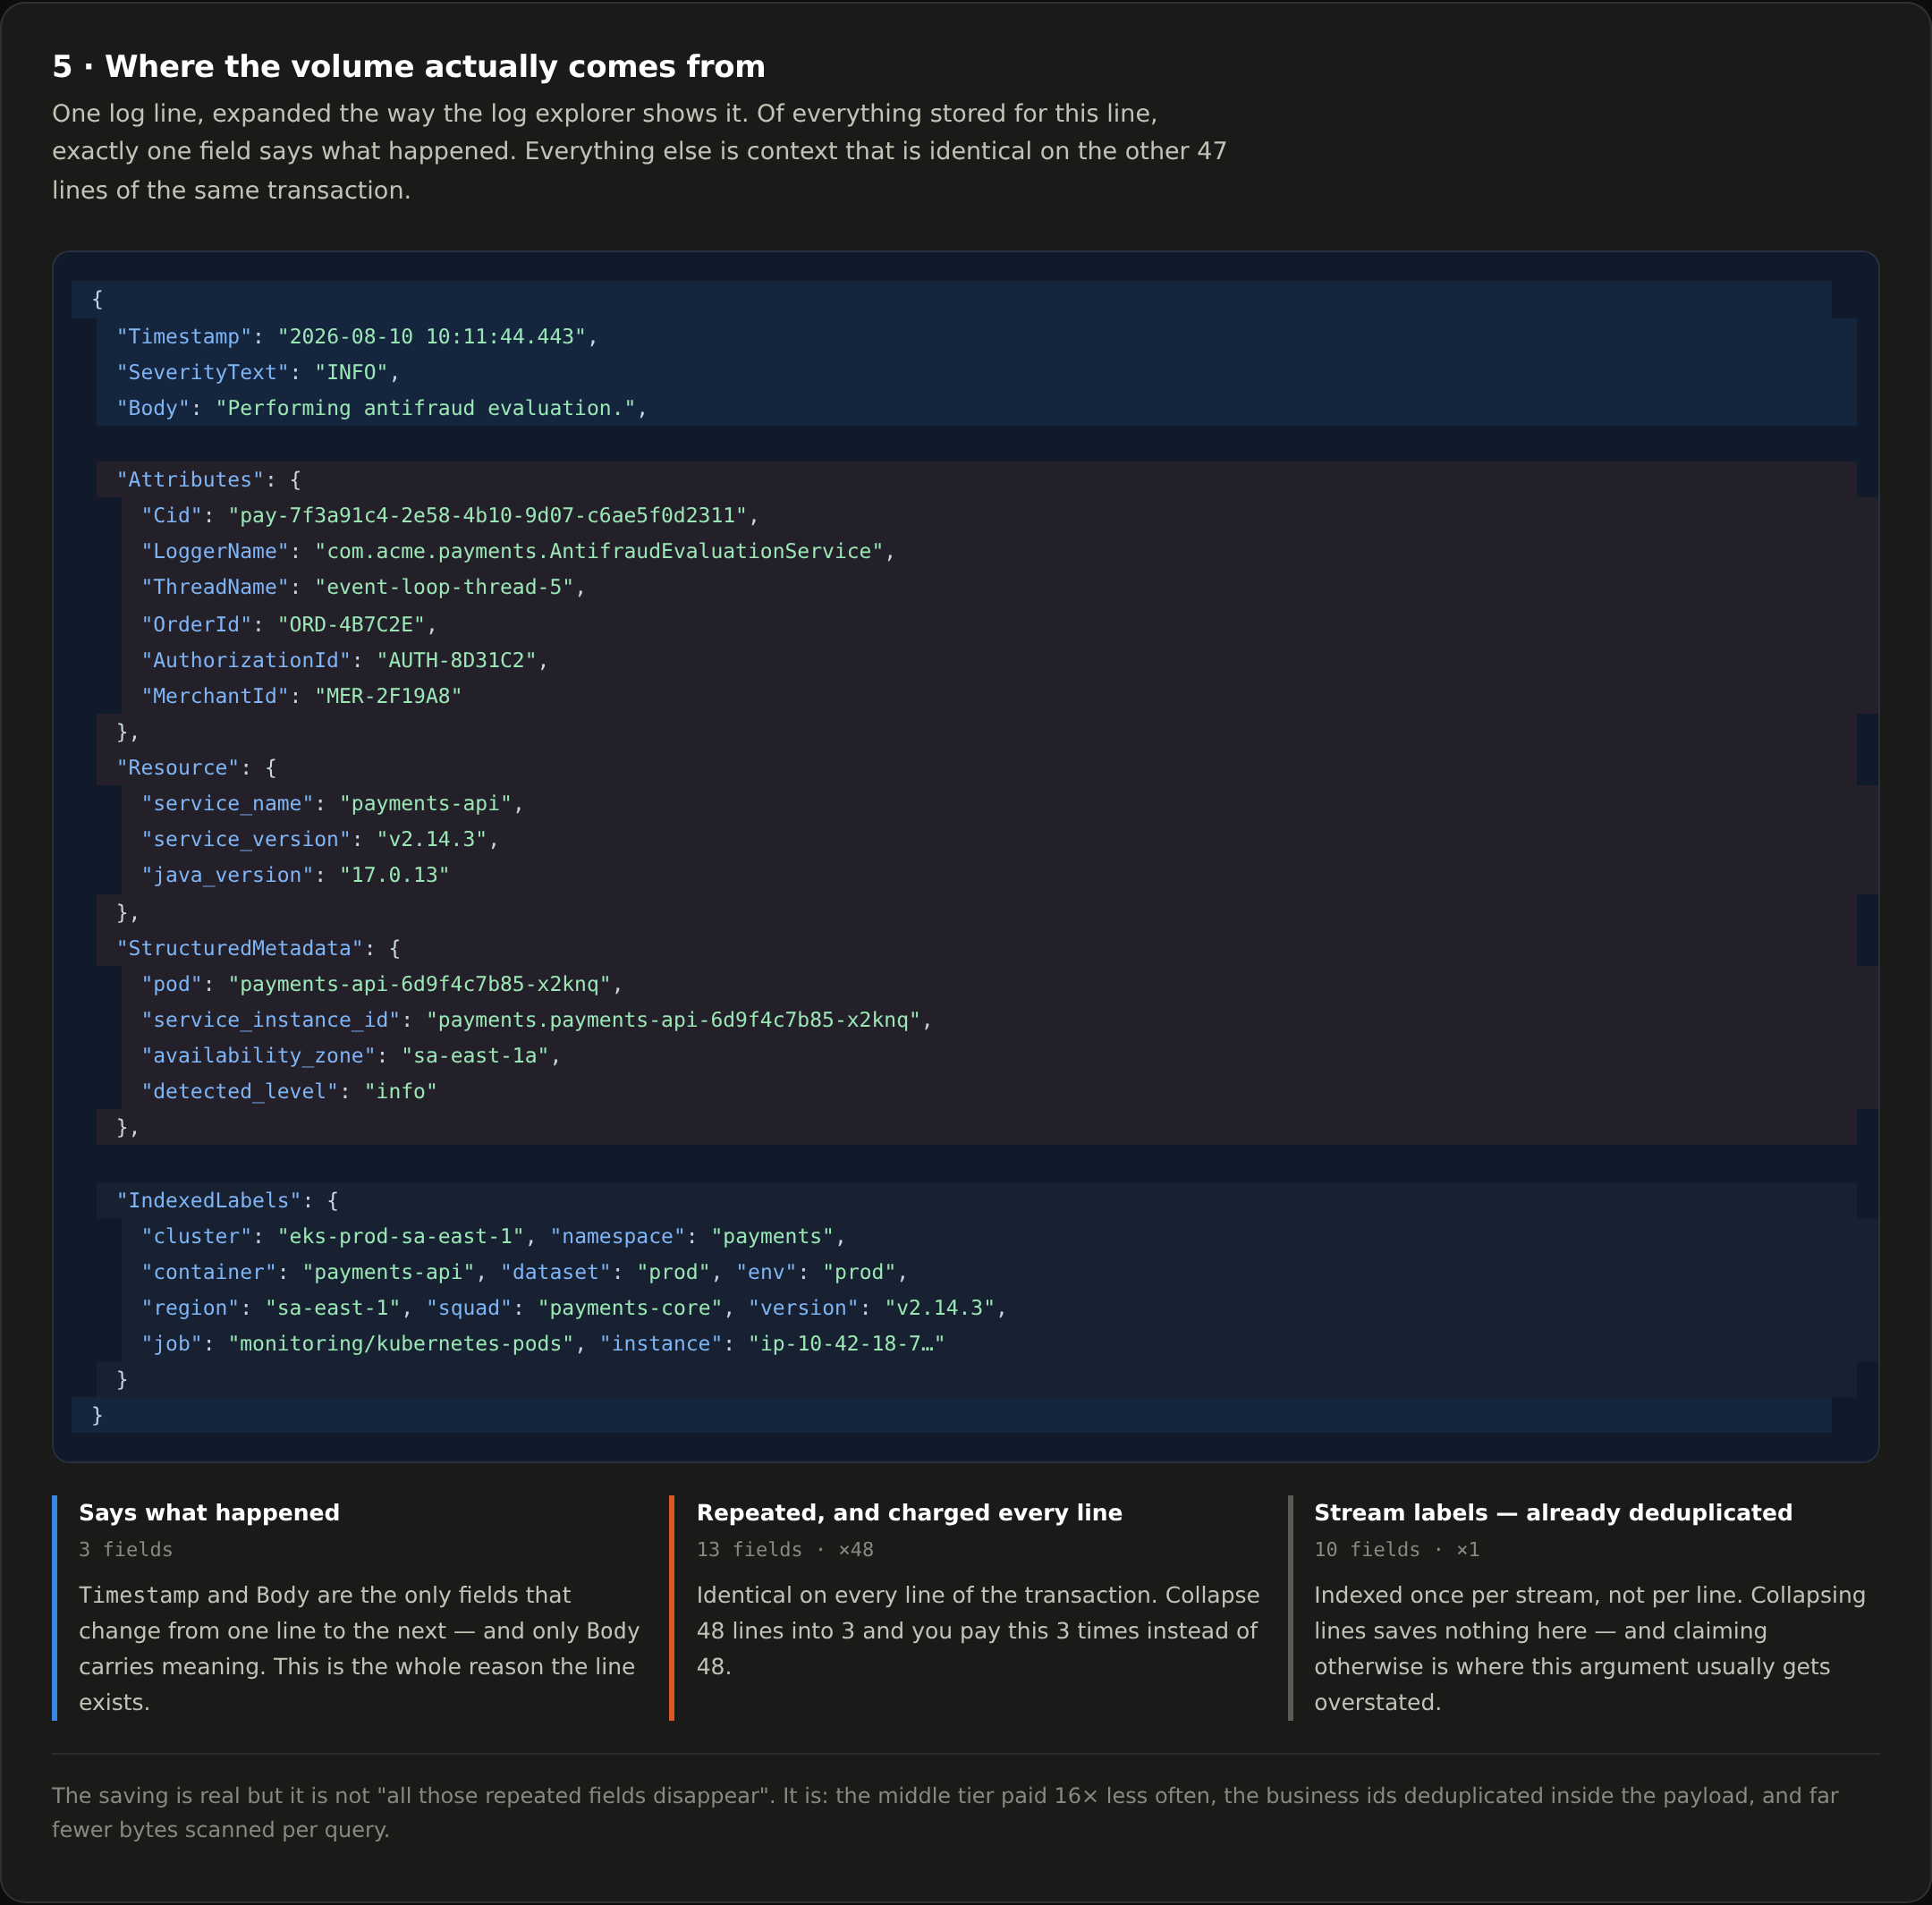
É aqui que wide events brilham: cortam linhas sem perder o stream de eventos que aconteceu. Corte as linhas em 16×, e você corta o carimbo em 16× — sem perder o que importa.
3. Log não é registro. É narrativa.
Vínhamos tratando log como transcrição de execução, um registro fiel de cada passo que o programa deu. Por esse critério, 48 linhas é um sucesso. Não falta nada.
Mas ninguém lê transcrição. Quando alguém abre um log às 3 da manhã, não está auditando execução. Está fazendo uma pergunta de história: o que aconteceu com esta transação, em que ordem, e onde deu errado?
Completude e legibilidade não são a mesma propriedade. A gente tinha maximizado uma e nunca medido a outra.
E narrativa se lê melhor resumida — com o detalhe disponível no instante em que você quiser. Isso não é concessão. É como toda outra forma de informação escrita funciona.
4. O acumulador
Em vez de escrever uma linha a cada passo, você mantém um acumulador no escopo da requisição. Cada passo anexa um evento. Nos checkpoints que significam alguma coisa no fluxo, você faz o flush.
no início da requisição:
  ctx.events  = []
  ctx.started = now()
  ctx.cid     = correlationFrom(request)

# substitui log.info("Performing antifraud evaluation.", attrs)
ctx.addEvent("Performing antifraud evaluation.", attrs)

# implementação do método que substitui log.info
addEvent(description, attrs = {}, level = INFO) {
  this.events.append({
      Description: description,
      OffsetMs:    now() - this.started,
      Attributes:  attrs,
      Level:       level
  })
}

# em cada checkpoint
flush(description, attrs = {}) {
  events = this.flushEvents()
  level  = greaterSeverity(events)
  attrs  = attrs << [
    EventCount: sizeOf(events),
    Events:     events
  ]

  log.onSeverity(this.cid, level, {
      Body:  description,
      Attrs: attrs
  })
}
Três decisões de design carregam quase todo o valor:
Checkpoints cortam fatias disjuntas. ctx.events é esvaziado em todo flush. Nenhum
evento aparece em duas linhas, e perder uma linha te custa exatamente aquela fatia do
fluxo, não a história inteira. Isso importa quando o problema de origem era perda de log.
OffsetMs é medido desde o início do fluxo, não entre passos. Offsets a partir de uma
origem única continuam fazendo sentido mesmo se uma linha se perder; deltas entre passos
adjacentes, não.
O texto das mensagens não muda. Passamos as strings originais sem alteração para o
Description. Toda query, alerta e dashboard que casava com texto de mensagem continuou
funcionando durante o rollout. É a diferença entre uma mudança que você sobe aos poucos e
uma que exige virada de chave coordenada.
5. O que merece virar evento
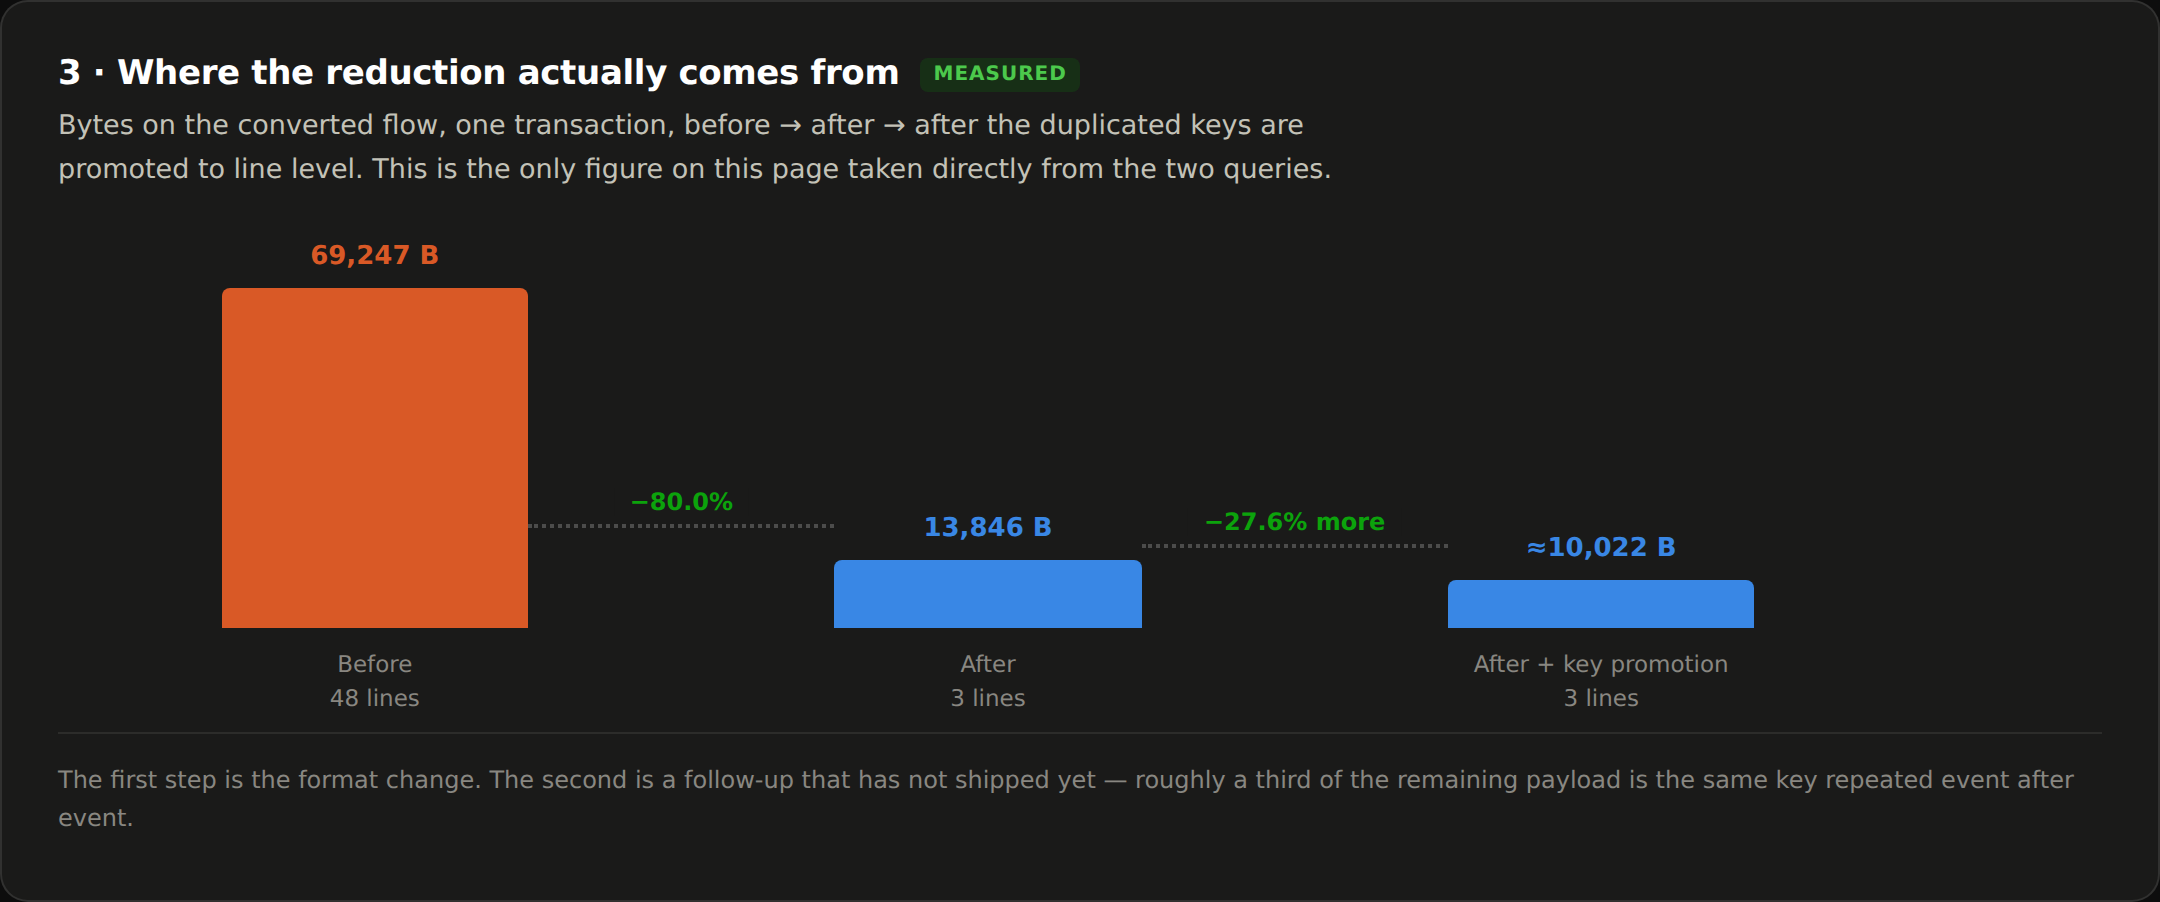
Colapsar 48 linhas em 3 é mecânico. E é a metade menor do ganho — se você parar aí, comprimiu o ruído em vez de remover.
A pergunta de verdade que o acumulador te obriga a responder é uma que o log linha a linha deixa você evitar pra sempre: o que de fato merece ser registrado?
Quando cada statement de log é uma linha própria, adicionar mais uma é de graça e ninguém revisa. Quando os eventos se acumulam num payload que você vai ler como uma narrativa só, um evento inútil fica visivelmente inútil — ele está ali no array, na sua frente, sem acrescentar nada.
O que mantivemos:
- Pontos de decisão. Qualquer lugar onde o fluxo poderia ter ido por outro caminho. "o pedido precisa de um novo código de segurança" merece um evento; o fato de que um foi gerado em seguida não precisa de um segundo.
- Fronteiras. Chamadas pra outro serviço, banco, cache e fila. É de onde vêm tempo e falha.
- Mudança de estado com valor de auditoria. As coisas que uma disputa ou um regulador vai perguntar depois. Em pagamentos, isso é quase o ponto inteiro.
- Valores que mudaram. Substituir um processing code, resolver um id de merchant — registre o resultado, não a intenção de fazer.
O que descartamos:
- Pares intenção/conclusão.
Building integrity key request.seguido deIntegrity request has built.é um evento, não dois, a menos que o intervalo entre eles seja algo que você algum dia vá medir. - Entrada e saída de método.
Receiving payment message.te informa que o handler que você já está olhando está rodando. - Reformulações.
Account was successfully found.logo depois deRetrieving Account.
Um teste grosseiro que se sustentou bem: se esse evento sumisse da narrativa, eu notaria, e ficaria pior? Se a resposta for não, aquilo nunca foi observabilidade — foi um log de debug que alguém deixou pra si mesmo enquanto escrevia o código, e que vem sendo faturado todo mês desde então.
Fizemos isso de forma conservadora — 48 linhas viraram 47 eventos, ou seja, quase não podamos na primeira passada. Foi deliberado: muda a forma primeiro, prova que nada quebrou, poda depois. É da poda que vêm os segundos 80%, e é muito mais fácil discutir sobre ela quando dá pra ver os 47 eventos juntos num lugar só.
6. Por que três linhas e não uma
Três não é número mágico nem boa prática: é o que o domínio do exemplo produziu. Portanto, não existe número certo — cada domínio terá o seu, e em muitos deles nunca vai ser necessário usar wide events.
Um checkpoint não é um intervalo de tempo, e não é uma contagem de eventos. É uma etapa do processo de negócio, nomeada na linguagem do negócio. Pra um fluxo de cartão isso significa coisas como: a requisição foi recebida e entendida; a decisão de autorização foi tomada e registrada; o resultado foi persistido e devolvido. Essas são as etapas que alguém usaria de verdade se você perguntasse o que aconteceu com uma transação. Ninguém nunca respondeu essa pergunta com "os primeiros 26 passos foram bem".
Acerte as etapas e o número cai sozinho. O nosso deu três. Uma captura com perna de liquidação daria quatro. Uma leitura simples dá uma — e uma está certo, é a forma canônica da literatura. Se a sua unidade de trabalho não tem etapas internas com significado, não invente pra bater um número.
O teste que mantém isso honesto: você consegue nomear o checkpoint sem se referir ao
código? OrderValidated e AuthorizationDecided significam alguma coisa pra quem nunca
abriu o repositório. Checkpoint2 e AfterServiceCall não — e um checkpoint que você não
consegue nomear em linguagem de domínio é um que não sobrevive ao próximo refactor, porque
não tem nada ancorando ele.
Uma vez que as etapas vêm do domínio, outras quatro coisas se encaixam, o que costuma ser sinal de que a fronteira está no lugar certo:
Uma linha perdida custa uma etapa, não a história. Perda de log sob carga é o que começa a maioria desses projetos. Se a narrativa inteira depende de uma linha, perder ela torna a transação invisível. Três fatias disjuntas significam que você perde um terço e ainda sabe que o fluxo existiu e mais ou menos onde ele parou.
Um fluxo que morre ainda deixa evidência. Um evento emitido no fim só existe se houver um fim. Crash, timeout ou uma mensagem envenenada no meio do parse, e um design de evento único te dá silêncio justamente nas transações que você mais precisa ver. Com etapas, você tem tudo até o último flush — e a ausência do próximo é, ela mesma, o sinal.
Etapas de domínio costumam coincidir com fronteiras de responsabilidade. Nossas três etapas por acaso são as fronteiras entre os componentes que as possuem, e o fluxo atravessa fronteiras assíncronas entre elas. Cada linha vem do componente que a produziu. Não é coincidência — é o que fronteiras de serviço bem desenhadas parecem quando funcionam.
Linhas têm limite prático de tamanho. 47 eventos com seus atributos num payload só é uma linha grande, e muitos pipelines truncam num tamanho fixo. Um wide event truncado é pior que vários íntegros, porque você perde a cauda silenciosamente.
O trade-off, dito com todas as letras: três linhas significam pagar o carimbo três vezes em vez de uma, e remontar o fluxo inteiro significa buscar três linhas em vez de uma. É um negócio que vale a pena quando durabilidade sob carga é o motivo pelo qual você começou.
7. Erro e warning não vão dentro do blob
Se uma falha vira uma entrada dentro de um array Events numa linha carimbada como INFO,
então todo alerta baseado em severidade para de disparar, seu error tracker não vê nada, o
dashboard filtrado em level=error fica em silêncio, e o gráfico em que todo mundo confia
mostra uma melhora que é inteiramente artefato da sua mudança de logging. Você vai ter
zerado sua taxa de erro tornando os erros inobserváveis.
Três regras resolvem.
1. A linha herda a maior severidade que ela carrega. Essa é a importante, e é o truque
inteiro. Um checkpoint não é INFO por padrão — sua severidade é a severidade máxima dos
eventos acumulados nele. Um evento WARN na fatia e a linha do checkpoint é emitida como
WARN. Um erro e ela é emitida como ERROR.
flush(description, attrs = {}) {
  events = this.flushEvents()
  level  = greaterSeverity(events)
  attrs  = attrs << [
    EventCount: sizeOf(events),
    Events:     events
  ]

  log.onSeverity(this.cid, level, {
      Body:  description,
      Attrs: attrs
  })
}
Severidade continua significando exatamente o que significava antes: tem alguma coisa aqui que um humano deveria olhar? Todo alerta, filtro e dashboard que se apoia em level continua funcionando sem saber nada do novo formato — e é isso que torna a mudança subível sem uma migração coordenada do seu alerting.
2. Erros também são emitidos na hora, em linha própria. Promoção de severidade não basta sozinha para erros, por dois motivos: o stack trace pertence a uma linha própria, não enfiado dentro de uma string de descrição, e uma exceção pode impedir que o flush aconteça. Então erros são escritos no momento em que ocorrem, exatamente como antes, e registrados no acumulador pra que a narrativa continue completa, com a falha em sequência e com seu offset. Sim, o erro aparece duas vezes. Essa duplicação é deliberada e barata, porque erro é raro — otimizar a contagem de bytes do seu caminho de erro é otimizar a coisa errada.
3. Contagens e desfecho ficam no nível da linha, não dentro do payload.
{
  "Cid": "...",
  "Body": "AuthorizationDecided",
  "EventCount": 16,
  "ErrorCount": 0,
  "WarnCount": 1,
  "Outcome": "degraded",
  "StatusCode": 202,
  "Events": [ ... ]
}
É isso que torna as perguntas interessantes baratas de fazer: quais fluxos completaram mas carregaram um warning, qual a taxa de erro por etapa, quais clientes veem desfecho degradado. Tudo filtro em campo, sem parsing de JSON no caminho da query.
E uma coisa fácil de esquecer: faça flush na saída de uma falha. Se uma exceção escapa
antes do próximo checkpoint, emita o que você tem e marque como fatia parcial. Os eventos
acumulados são mais valiosos justamente quando o fluxo não terminou, e um finally que faz
flush é a diferença entre ter essa história e perder ela.
8. Como fica depois
Três linhas. O resumo é a visão padrão:
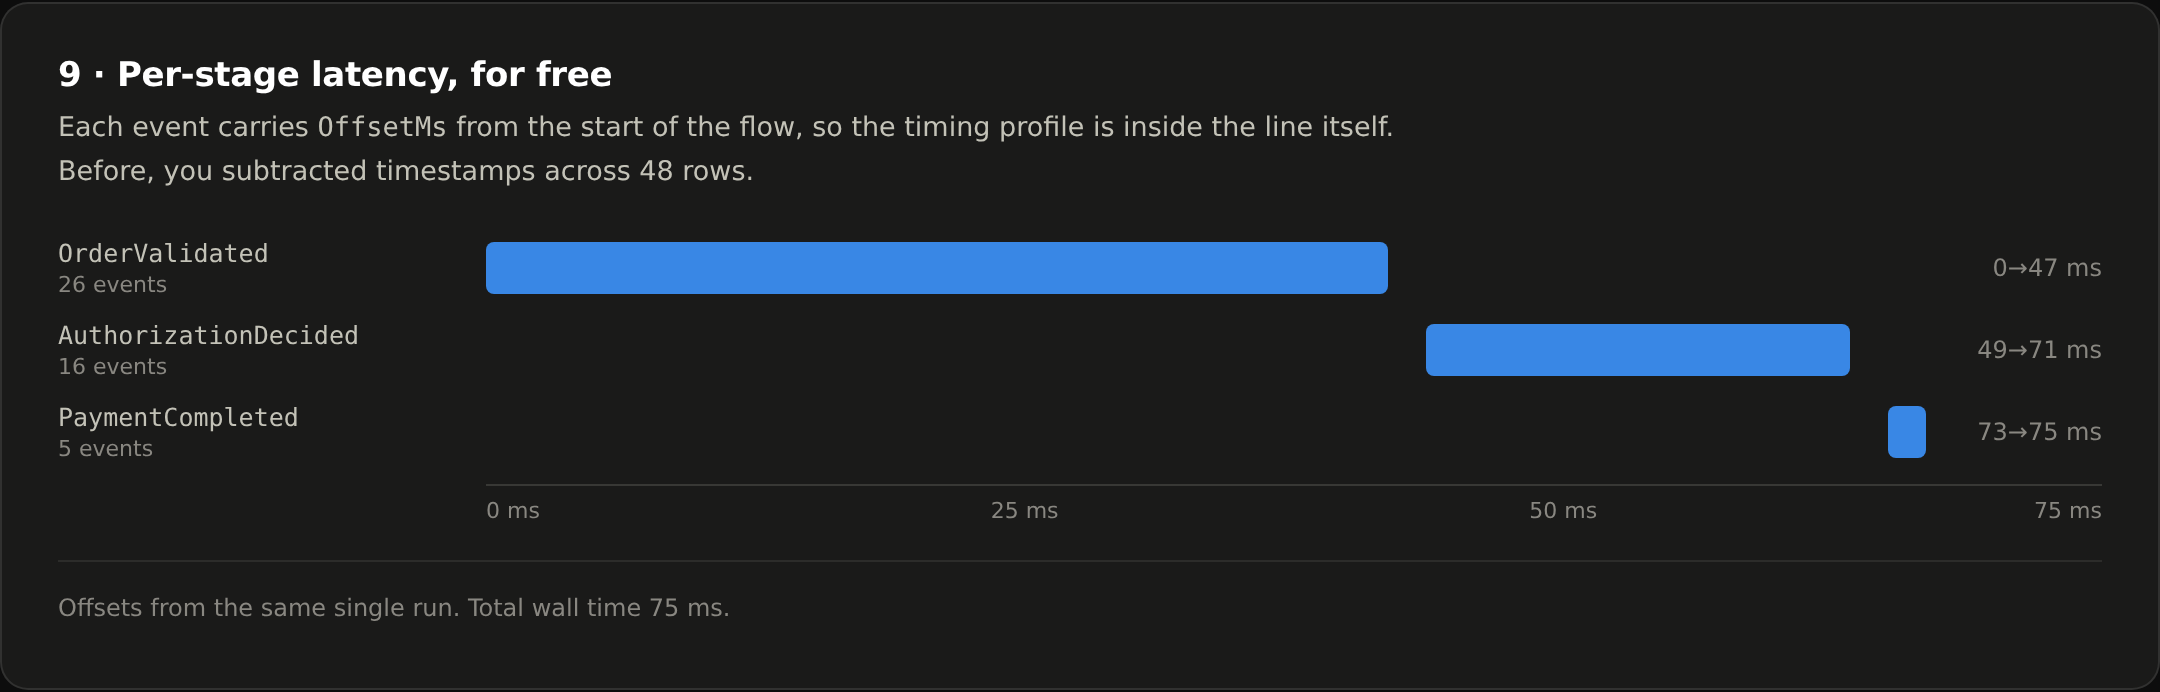
OrderValidated        · OrderService          · EventCount 26 · 0→47 ms
AuthorizationDecided  · AuthorizationService  · EventCount 16 · 49→71 ms
PaymentCompleted      · PaymentHandler        · EventCount  5 · 73→75 ms · 202
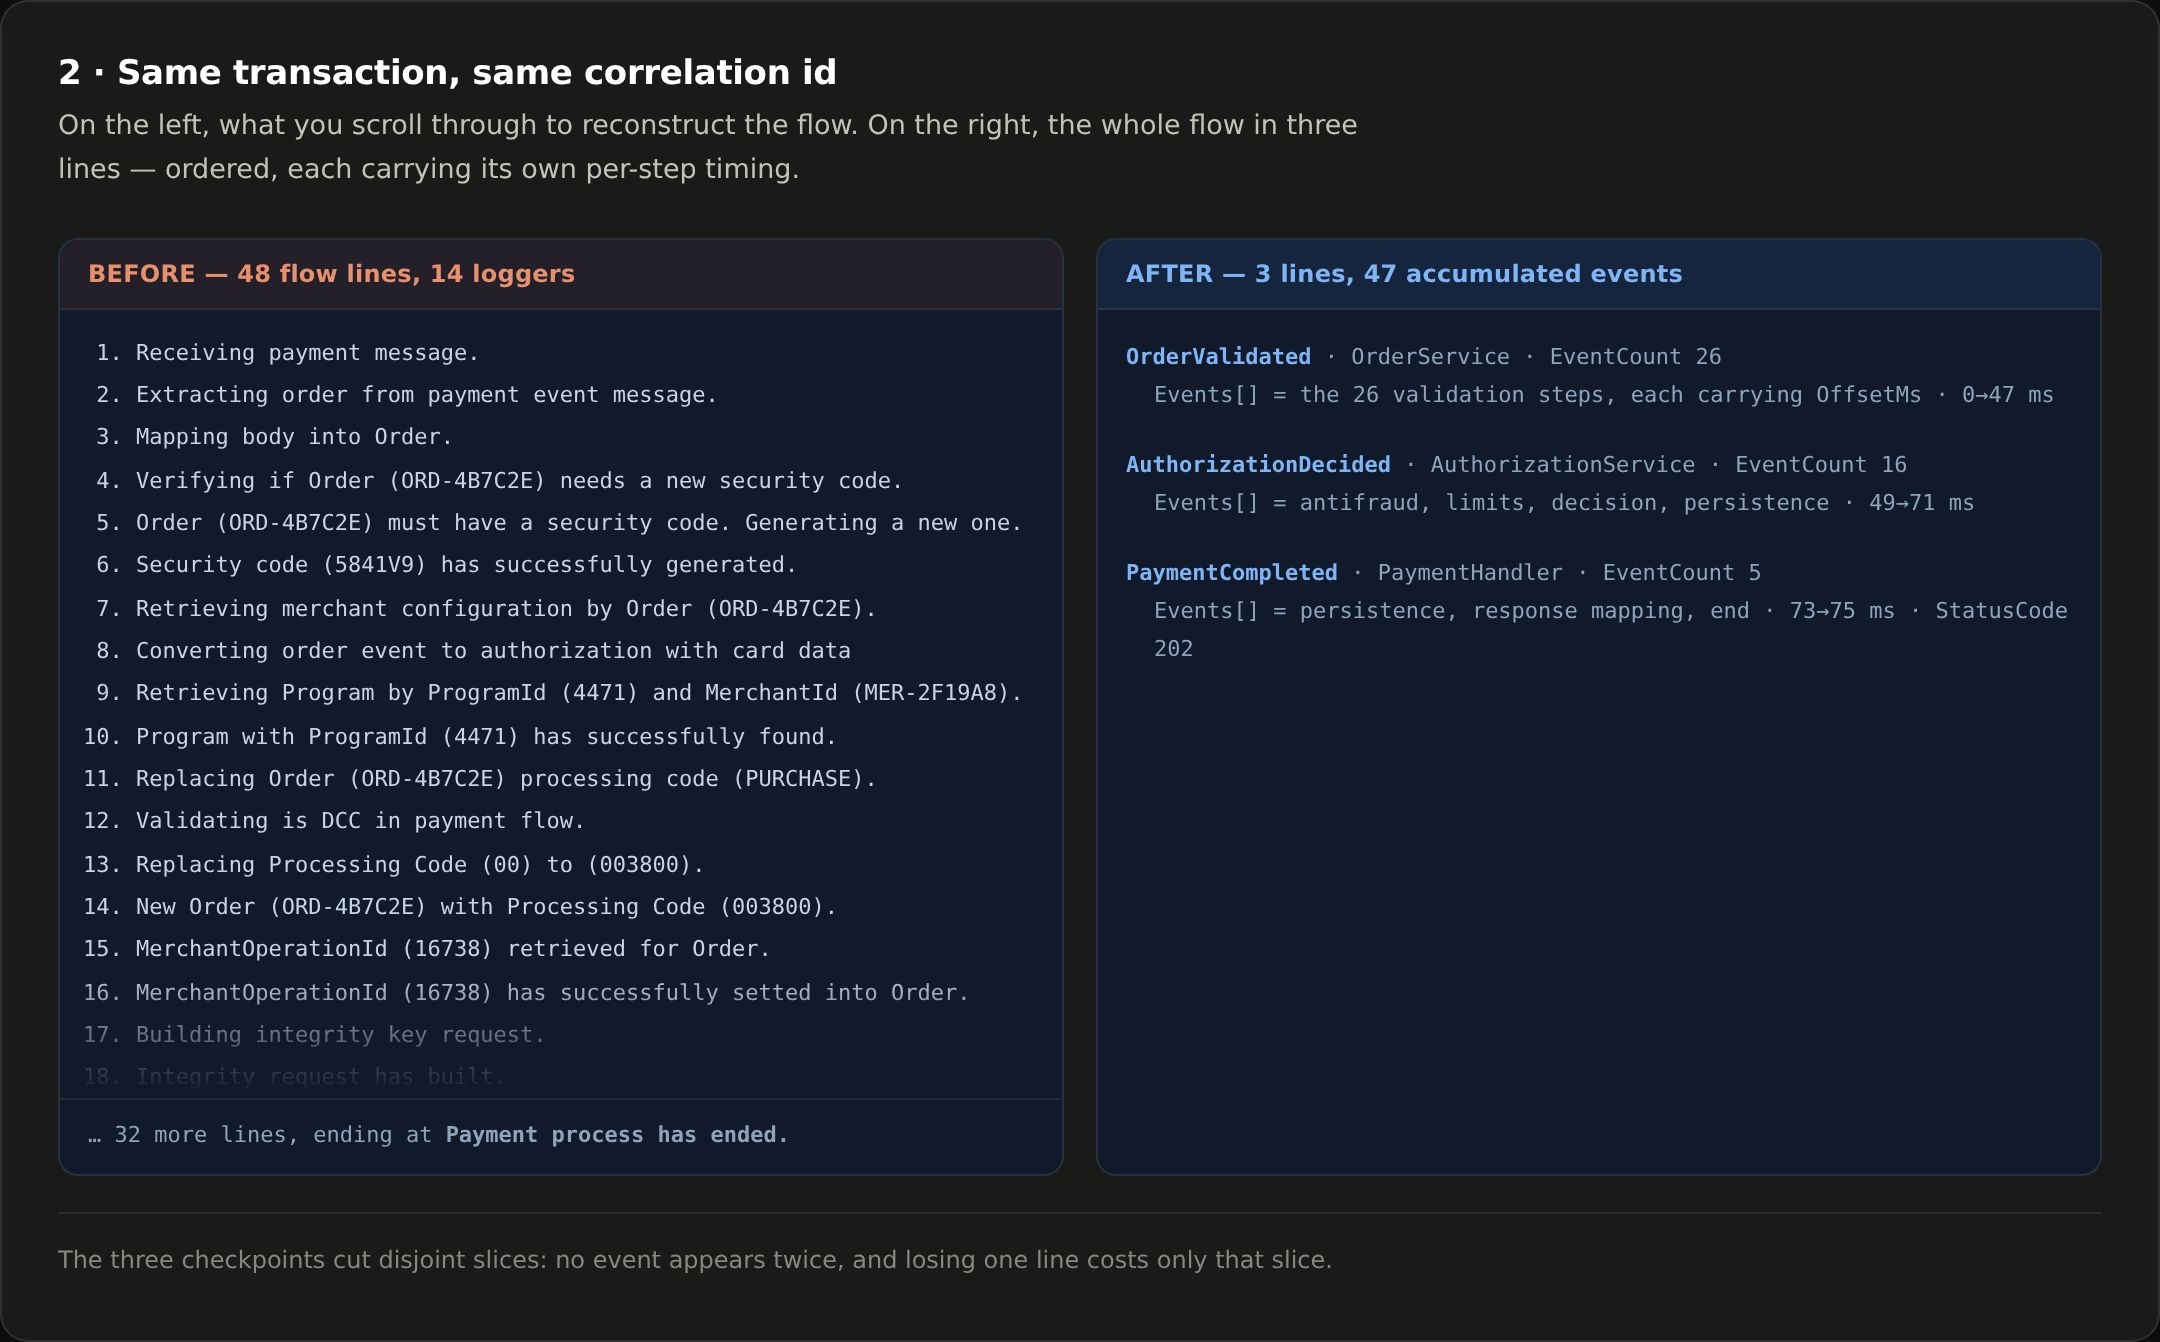
E o passo a passo está a um clique de distância:
{
  "Cid": "pay-7f3a91c4-2e58-4b10-9d07-c6ae5f0d2311",
  "Body": "OrderValidated",
  "EventCount": 26,
  "Events": [
    { "Description": "PaymentReceived", "OffsetMs": 0, "Attributes": { "Ingress": "sqs" } },
    { "Description": "Mapping body into Order.", "OffsetMs": 0 },
    { "Description": "Performing antifraud evaluation.", "OffsetMs": 10,
      "Attributes": { "AuthorizationId": "AUTH-8D31C2", "MerchantId": "MER-2F19A8" } }
  ]
}
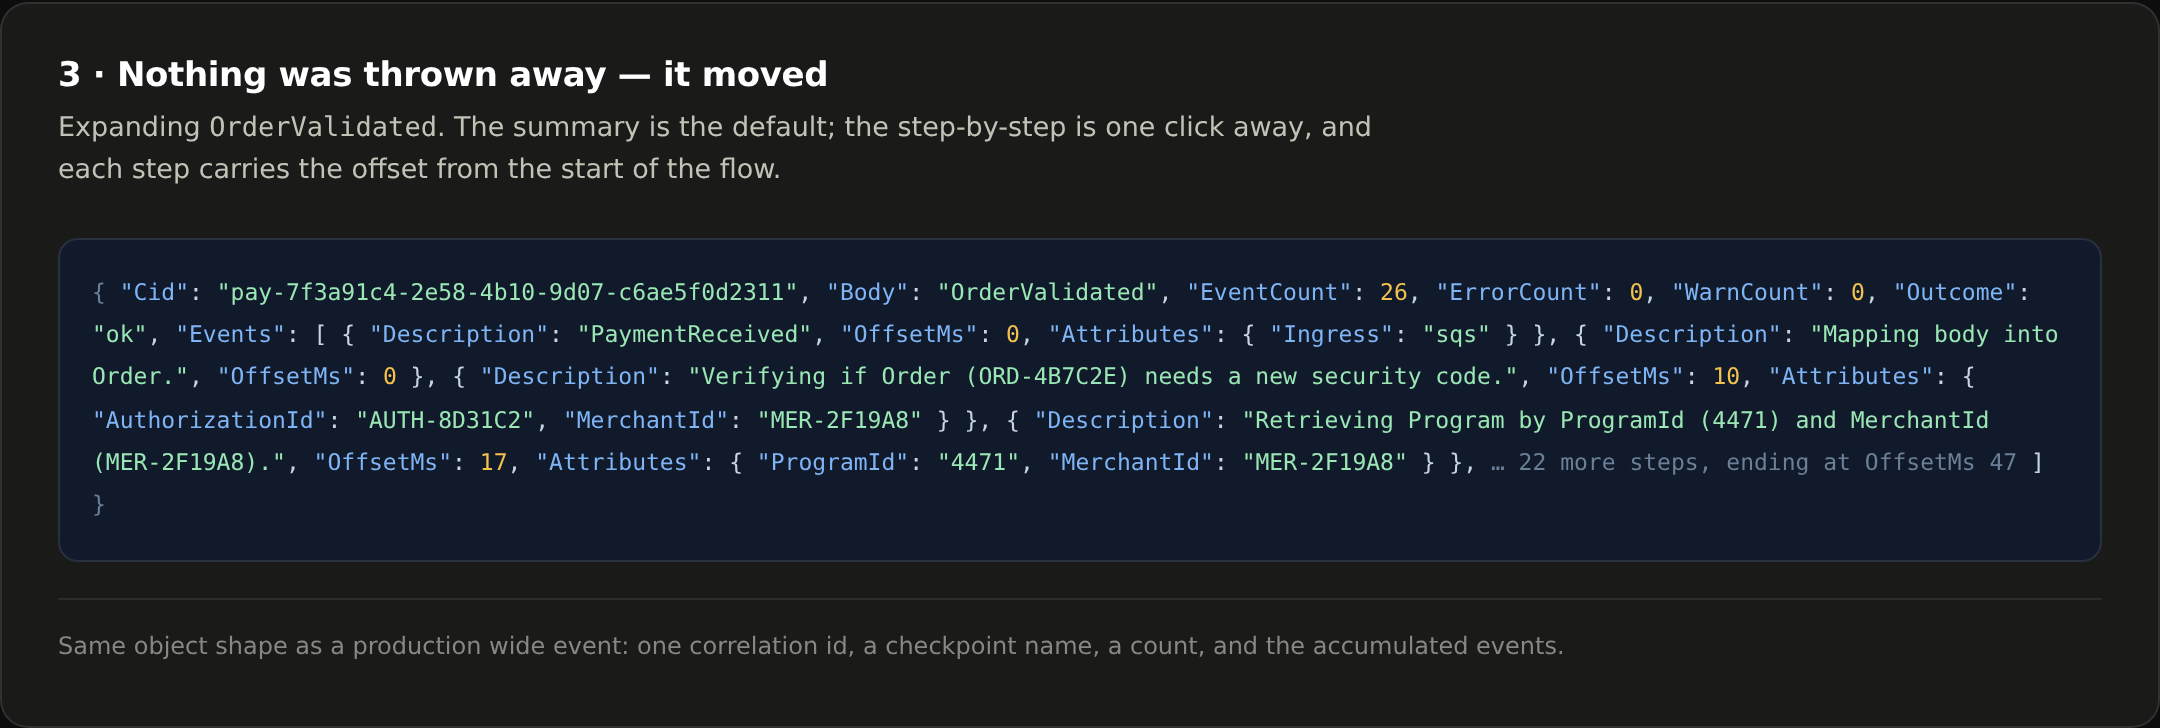
Nada foi apagado. Mudou de lugar. 47 eventos de negócio continuam registrados, agora carregados por 3 linhas em vez de 48 — e cada um chega com seu próprio offset, então o perfil de latência do fluxo está dentro da linha. Antes, você conseguia isso subtraindo timestamps ao longo de 48 linhas.
9. Números
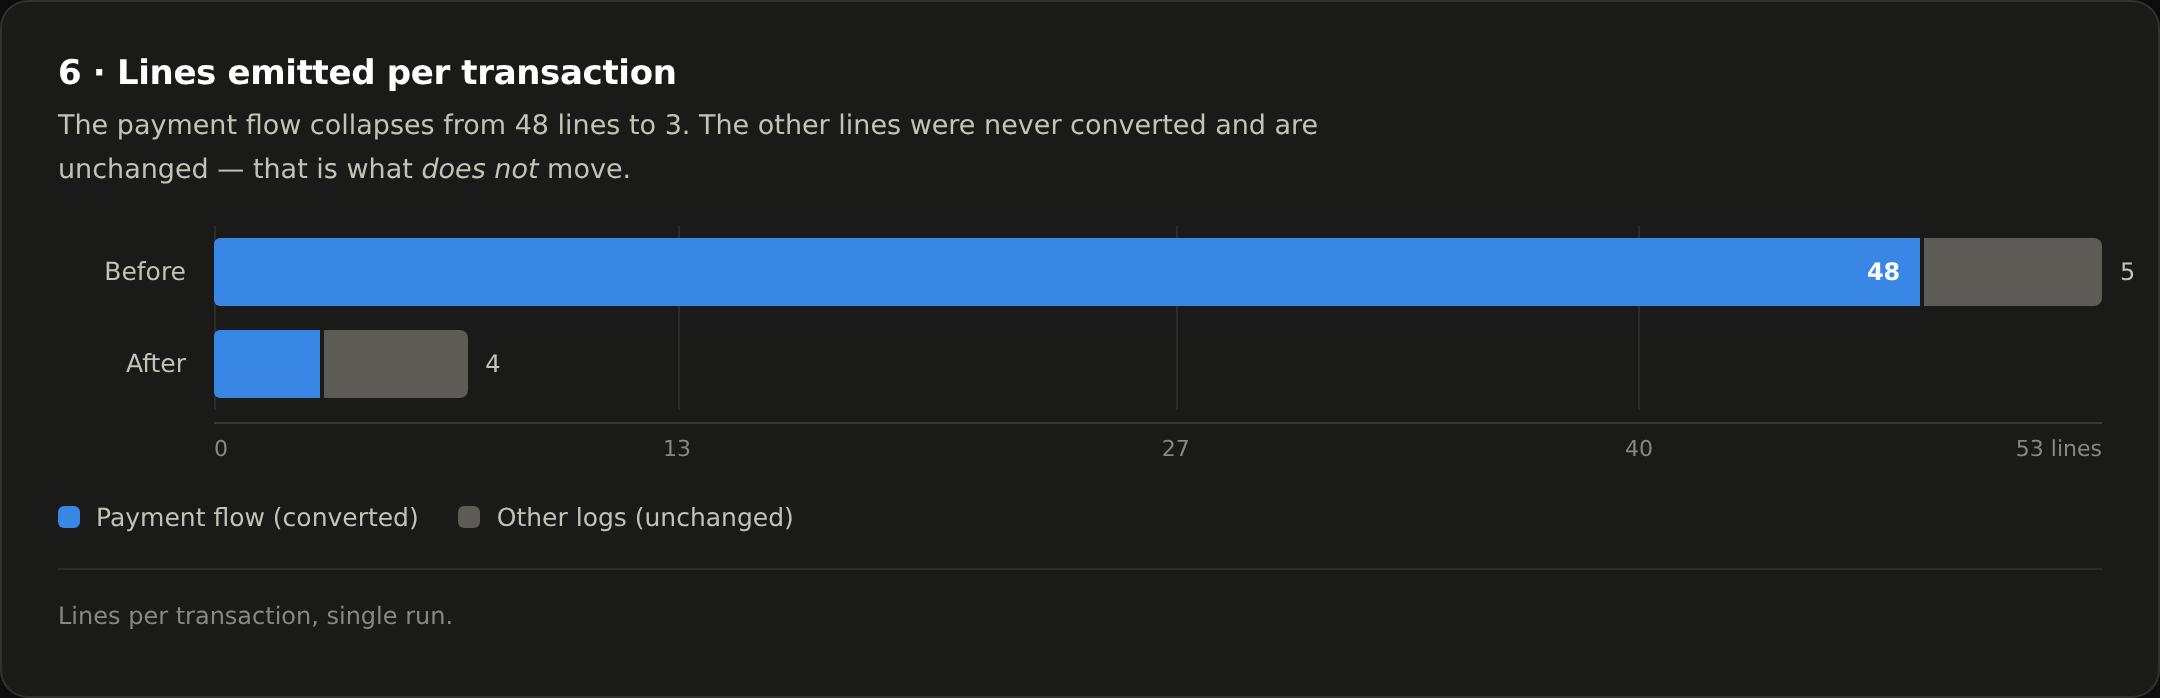
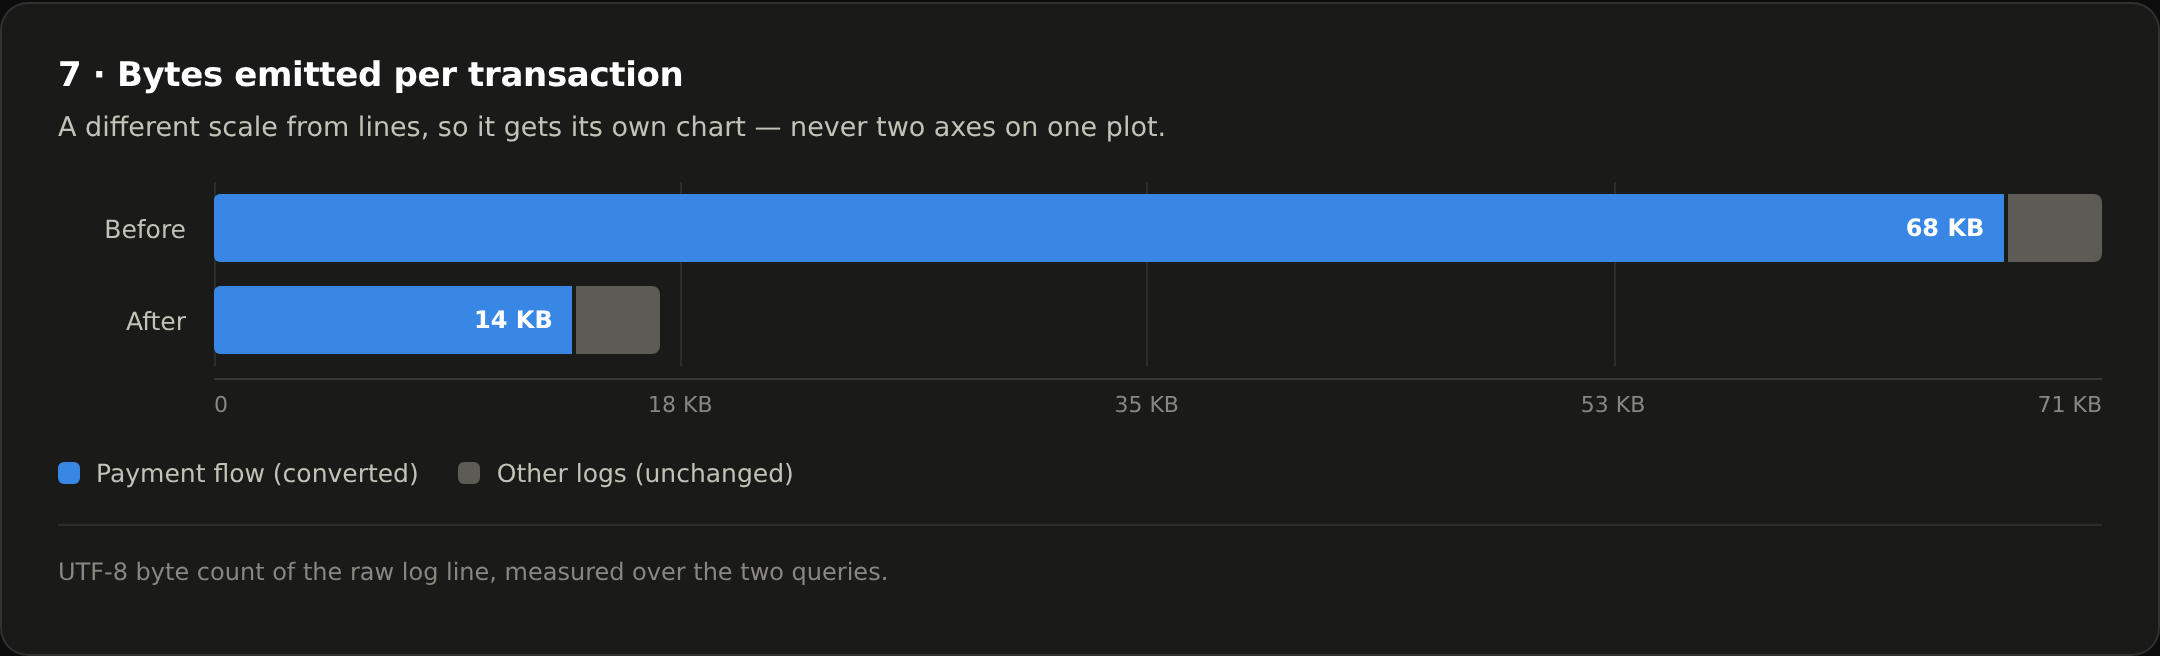
Metodologia primeiro, porque ela delimita o que esses números significam. Uma transação, medida ponta a ponta, em ambiente de pré-produção, antes e depois da mudança. As contagens de bytes são UTF-8 sobre a linha de log crua. Isso é uma indicação de ordem de grandeza, não uma média de produção, e o seu sistema não é o sistema medido aqui.
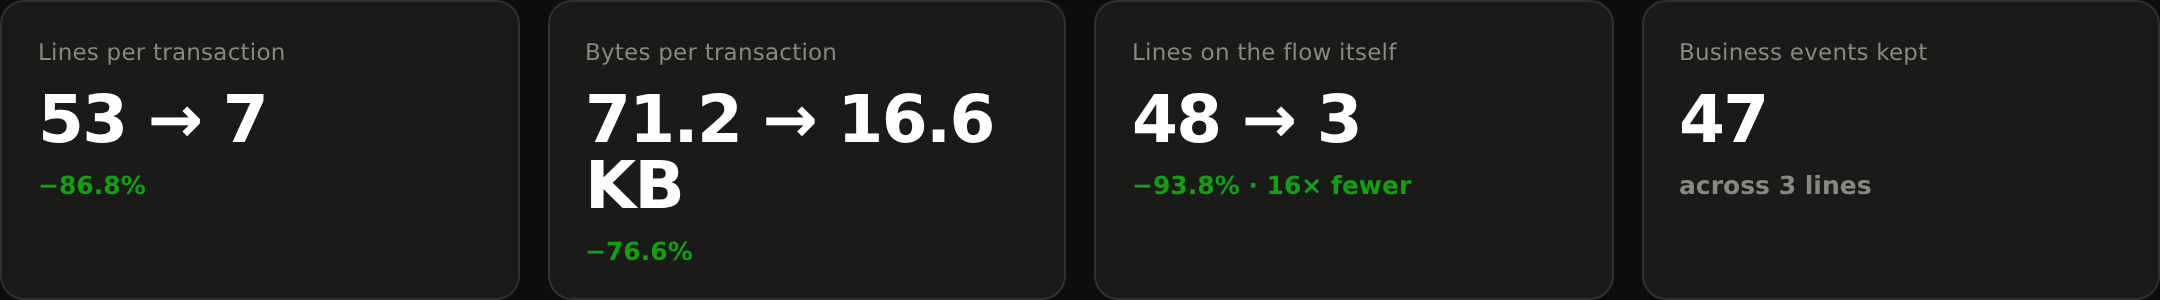
| Métrica | Antes | Depois | Δ |
|---|---|---|---|
| Linhas totais | 53 | 7 | −86,8% |
| Linhas — fluxo de pagamento | 48 | 3 | −93,8% |
| Linhas — outros logs | 5 | 4 | inalterado |
| Bytes totais | 72.871 | 17.035 | −76,6% |
| Bytes — fluxo de pagamento | 69.247 | 13.846 | −80,0% |
| Bytes por linha (média) | 1.374 | 2.433 | +77% |
| Eventos de negócio registrados | 48 linhas | 47 eventos | preservados |
| Bytes varridos pela query | 2,19 MB | 240 kB | −89,0% |
Duas linhas da tabela merecem comentário.
Bytes por linha subiram 77%. Isso não é efeito colateral, é o mecanismo. Uma linha agora carrega uma fatia inteira do fluxo. Se esse número não tivesse subido, a mudança não teria funcionado.
As linhas que não foram convertidas não se mexeram. Cinco outras linhas de log estavam na mesma janela e continuaram exatamente como estavam. Vale mostrar o que não muda — números de antes/depois que melhoram uniformemente normalmente estão medindo outra coisa que não a que dizem medir.
10. O que ainda dá pra cortar
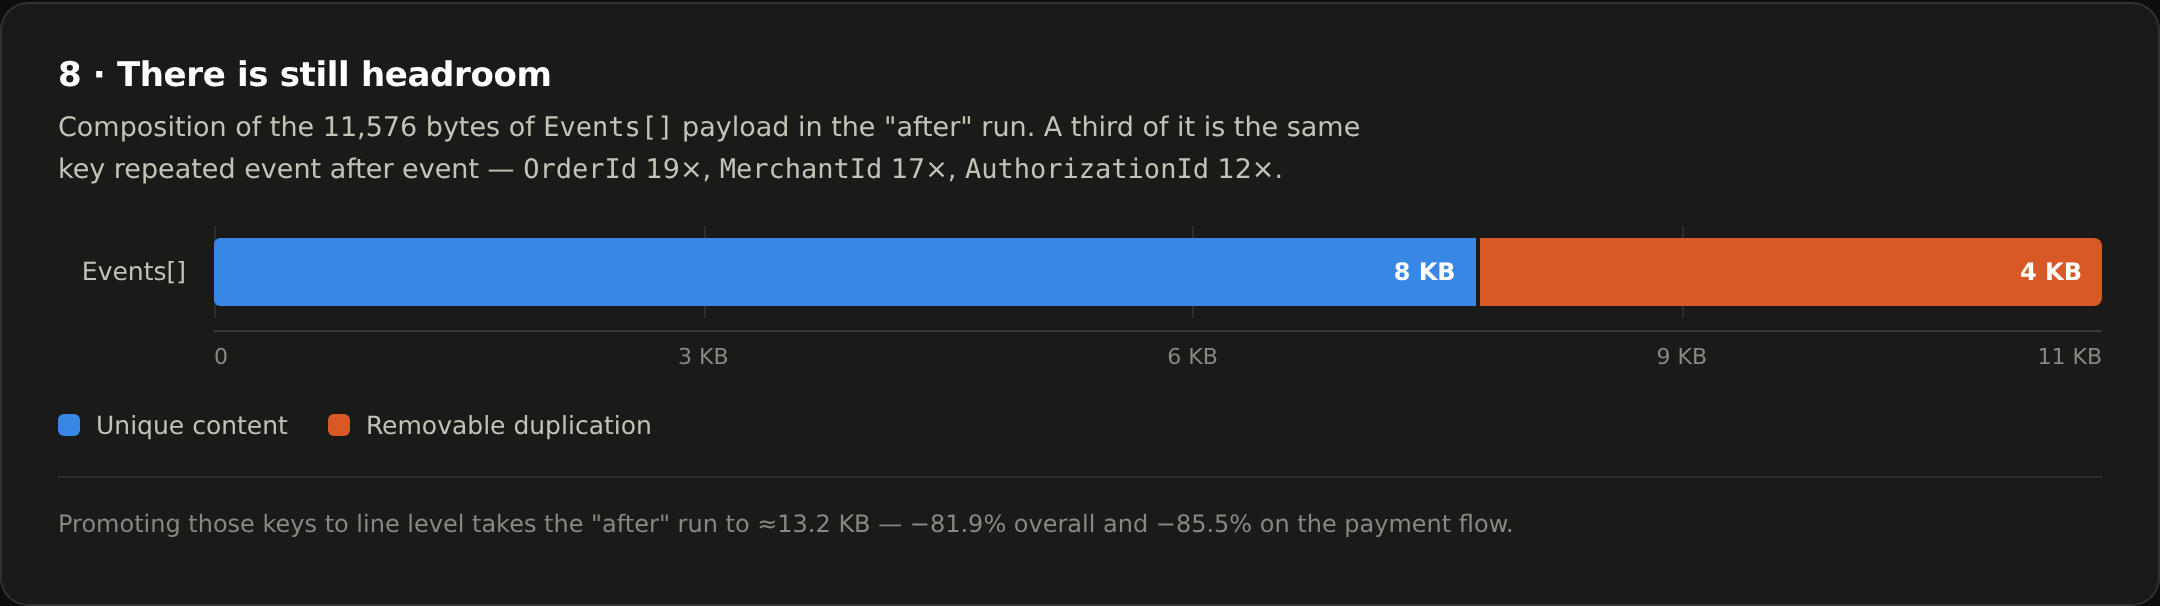
Medimos a composição do payload resultante, e cerca de um terço dele é a mesma chave repetida
evento após evento dentro de uma única linha: OrderId 19 vezes, MerchantId 17 vezes,
AuthorizationId 12 vezes.
Essas são propriedades do fluxo, não de passos individuais. Promover elas pro nível da linha projeta ≈13,2 KB — −81,9% no total, −85,5% no próprio fluxo.
A regra geral que sai daí: um atributo que é constante para a unidade de trabalho inteira pertence à linha, não ao evento. A gente errou isso na primeira vez, traduzindo mecanicamente cada linha de log existente num evento com os atributos que ela por acaso carregava.
11. Quando não fazer isso
Processo longo e streaming. Um wide event é emitido quando uma fatia se completa. Se sua unidade de trabalho é um batch de seis horas ou um WebSocket aberto, você não tem telemetria nenhuma até terminar — e nenhuma se nunca terminar. Checkpoints amenizam; não resolvem. Laban Eilers, escrevendo a partir da experiência de produção da SimpliSafe, é direto ao dizer que spans de longa duração são um problema amplamente não resolvido.
Debug dentro de um único passo. Um wide event é resumo, e resumo perde sequência. Ele vai te dizer que a etapa de persistência levou 22 ms; não vai te dizer qual branch o handler pegou. Perguntas entre requisições são o que esse formato faz bem. Causalidade dentro da requisição ainda pede span ou log de debug comum. Quem te disser pra apagar todos os seus logs está vendendo demais.
Backends que punem alta cardinalidade. Tudo aqui pressupõe que você consegue consultar campos com muitos valores distintos. Se o seu armazenamento indexa labels de baixa cardinalidade e faz força bruta no resto, você vai sentir.
Schema drift. Wide events acumulam campos ao longo dos anos do mesmo jeito que linhas de log acumulam linhas. O modo de falha é adiado, não evitado.
Sistemas que já logam cinco linhas por requisição. Você não tem esse problema. Vá fazer outra coisa.
Os ganhos aqui são específicos de um sistema, e não há garantia de que se repitam. Mas se o seu log serve como trilha de auditoria — pagamento, razão contábil, qualquer coisa que um regulador ou um processo de disputa possa ler — então legibilidade não é estética. É a diferença entre reconstruir um incidente em dois minutos e reconstruir em quarenta.
12. Isso não é só um span?
É o mesmo instinto, e a resposta honesta é que as ideias se sobrepõem bastante.
Um wide event é próximo do que você tem de um root span bem atribuído. Se você já roda OpenTelemetry ponta a ponta e seu backend consulta atributos de span com conforto, coloque esses campos no span e pare de ler.
O motivo pra fazer isso no stream de log: em sistemas como esse, log é o registro de auditoria durável e consultável. Ele é retido num calendário diferente do dos traces, lido por gente que não usa a UI de tracing, e referenciado em processos que não têm nada a ver com engenharia. Tirar a narrativa desse stream teria resolvido um problema de legibilidade criando um problema de acesso.
Os dois são complementares, não concorrentes. Trace responde onde na topologia; wide event responde o que aconteceu com esta unidade de trabalho.
13. De onde a ideia vem
Nada disso é novo, e vale ler quem chegou lá primeiro:
- Brandur Leach, Using Canonical Log Lines for Online Visibility (2016) — o texto original, e ainda o mais claro.
- Stripe, Fast and flexible observability with canonical log lines (2019).
- Jeremy Morrell, A Practitioner's Guide to Wide Events (2024) — o guia mais completo sobre o que pertence ao evento.
- Ivan Burmistrov, All you need is Wide Events, not "Metrics, Logs and Traces" (2024) — a forma forte do argumento.
- Abraham et al., Scuba: Diving into Data at Facebook (2013) — o paper de sistemas por baixo de tudo isso.
14. Como começar
Um serviço. Um fluxo. Três checkpoints.
Meça antes de mudar qualquer coisa — linhas e bytes por unidade de trabalho, e os bytes que sua query habitual varre. Sem uma linha de base você vai ter uma opinião, não um resultado.
Preserve as strings originais das mensagens pra que nada quebre downstream. Suba atrás de uma flag, rode os dois por uma semana, compare.
Depois faça a pergunta que começou tudo isso, sobre qualquer outra coisa que esteja pegando fogo agora:
Estamos resolvendo, ou estamos pagando pra não ter que resolver?
Às vezes pagar é genuinamente a resposta certa. Só vale saber qual das duas você escolheu.
Apêndice — como isso fica em escala
Tudo neste apêndice é modelo, não medição. Pega as contagens de bytes por transação medidas acima e multiplica por uma premissa de tráfego. Mostra a forma da economia, não uma promessa — sua contagem de linhas, o tamanho das suas linhas, sua vazão e seu preço são todos diferentes.
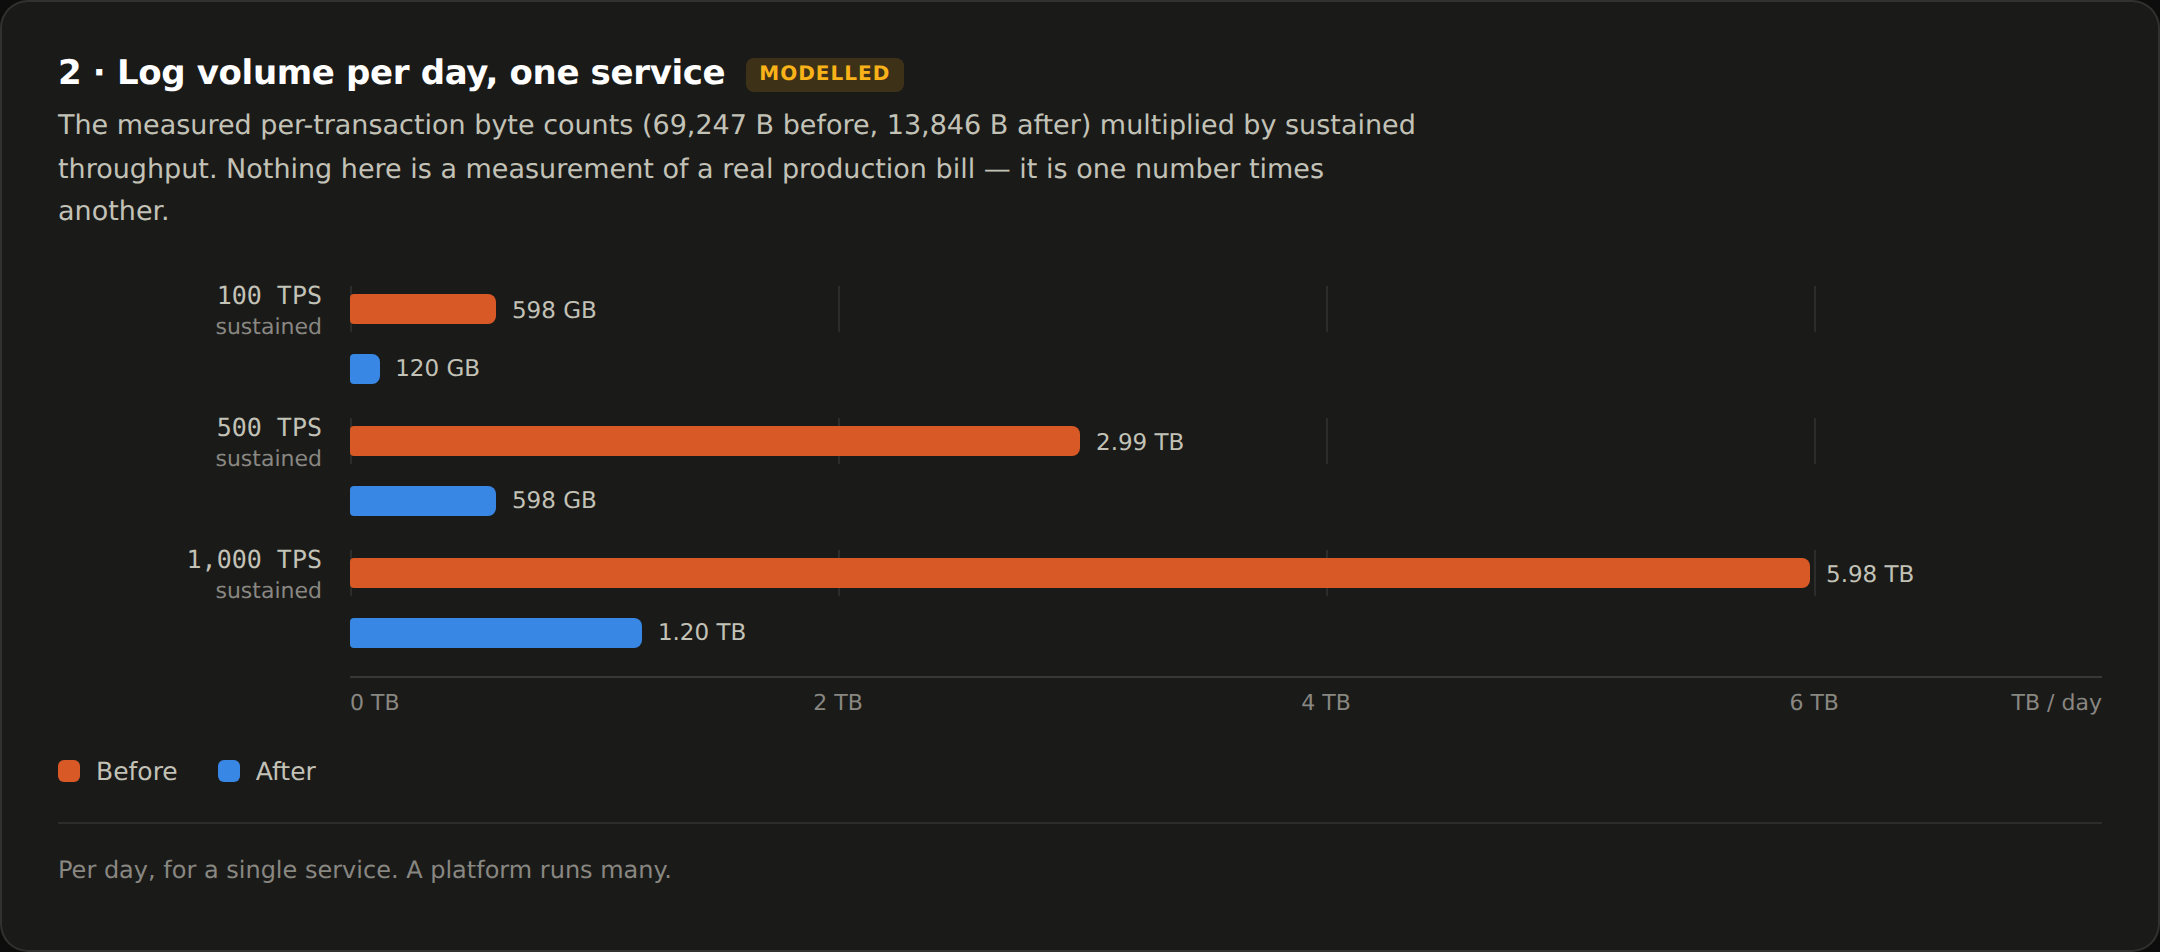
Não existe jeito honesto de publicar um valor em dinheiro que se aplique à sua plataforma: preço de ingestão varia numa ordem de grandeza entre fornecedores, tiers e compromissos. Então aqui está a mesma aritmética com a taxa deixada como sua entrada.
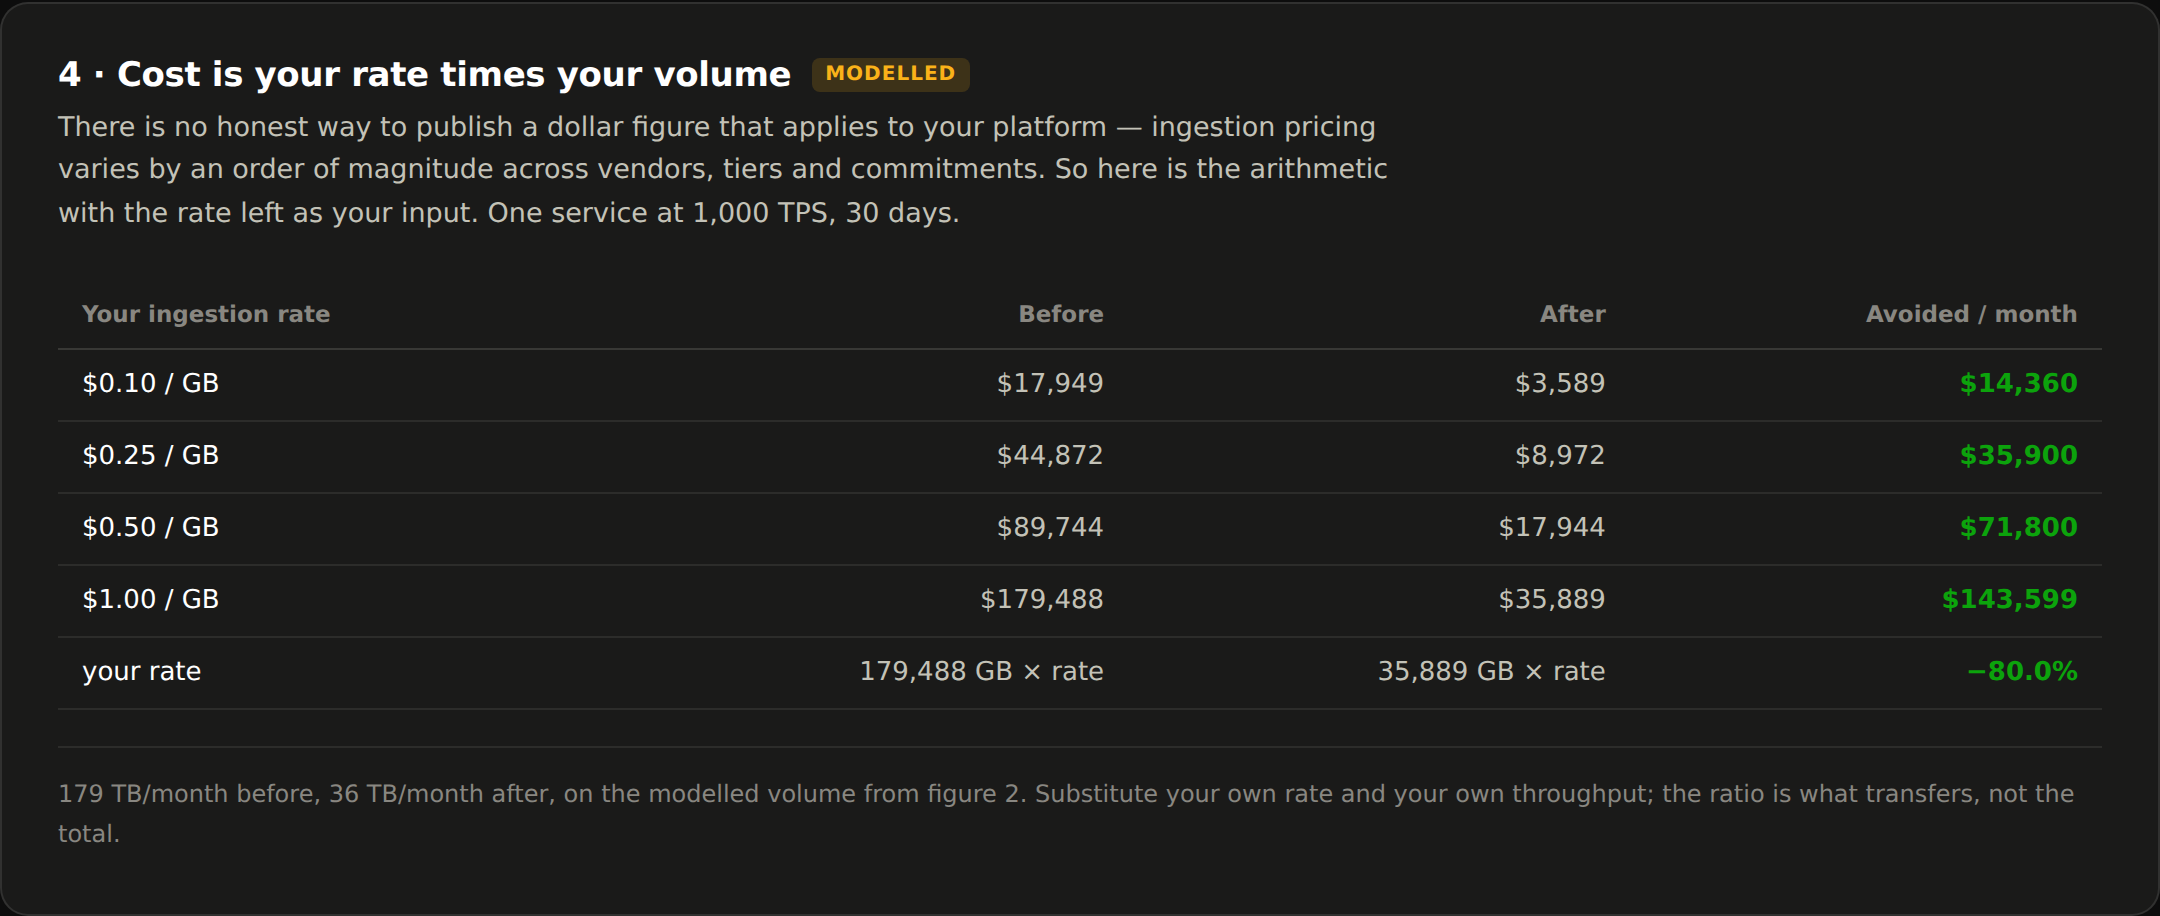
A razão é o que se transfere. O total, não.